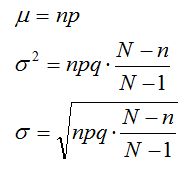viernes, 28 de junio de 2019

Distribución de Poisson


En teoría de probabilidad y estadística, la distribución de Poisson es una distribución de probabilidad discreta que expresa, a partir de una frecuencia de ocurrencia media, la probabilidad de que ocurra un determinado número de eventos durante cierto período de tiempo. Concretamente, se especializa en la probabilidad de ocurrencia de sucesos con probabilidades muy pequeñas, o sucesos "raros".
Fue descubierta por Siméon-Denis Poisson, que la dio a conocer en 1838 en su trabajo Recherches sur la probabilité des jugements en matières criminelles et matière civile (Investigación sobre la probabilidad de los juicios en materias criminales y civiles).

Propiedades

la función de densidad de probabilidad de la distribución de Poisson es

donde
  • k es el número de ocurrencias del evento o fenómeno (la función nos da la probabilidad de que el evento suceda precisamente k veces).
  • λ es un parámetro positivo que representa el número de veces que se espera que ocurra el fenómeno durante un intervalo dado. Por ejemplo, si el suceso estudiado tiene lugar en promedio 4 veces por minuto y estamos interesados en la probabilidad de que ocurra k veces dentro de un intervalo de 10 minutos, usaremos un modelo de distribución de Poisson con λ = 10×4 = 40.
  • e es la base de los logaritmos naturales (e = 2,71828...)
Tanto el valor esperado como la varianza de una variable aleatoria con distribución de Poisson son iguales a λ. Los momentos de orden superior son polinomios de Touchard en λ cuyos coeficientes tienen una interpretación combinatoria. De hecho, cuando el valor esperado de la distribución de Poisson es 1, entonces según la fórmula de Dobinski, el n-ésimo momento iguala al número de particiones de tamaño n.
La moda de una variable aleatoria de distribución de Poisson con un λ no entero es igual a , el mayor de los enteros menores que λ (los símbolos  representan la función parte entera). Cuando λ es un entero positivo, las modas son λ y λ − 1.
La función generadora de momentos de la distribución de Poisson con valor esperado λ es
Las variables aleatorias de Poisson tienen la propiedad de ser infinitamente divisibles.
La divergencia Kullback-Leibler desde una variable aleatoria de Poisson de parámetro λ0 a otra de parámetro λ es

EJEMPLO

Si un banco recibe en promedio 6 cheques sin fondo por día, ¿cuáles son las probabilidades de que reciba, a) cuatro cheques sin fondo en un día dado, b) 10 cheques sin fondos en cualquiera de dos días consecutivos?


Solución:
a)      x = variable que nos define el número de cheques sin fondo que llegan al banco en un día cualquiera = 0, 1, 2, 3, ....., etc, etc.
l = 6 cheques sin fondo por día
e = 2.718


b)
x= variable que nos define el número de cheques sin fondo que llegan al banco en dos días consecutivos = 0, 1, 2, 3, ......, etc., etc.
l = 6 x 2 = 12 cheques sin fondo en promedio que  llegan al banco en dos días consecutivos
Nota: l siempre debe de estar en función de x siempre o dicho de otra forma, debe “hablar” de lo mismo que x.

                         http://www.itchihuahua.edu.mx/academic/industrial/sabaticorita/_private/05Distr%20Poisson_archivos/image006.gif


PARA RESOLVER
En la inspección de hojalata producida por un proceso electrolítico continuo, se identifican 0.2 imperfecciones en promedio por minuto. Determine las probabilidades de identificar a) una imperfección en 3 minutos, b) al menos dos imperfecciones en 5 minutos, c) cuando más una imperfección en 15 minutos. 

Distribución hipergeométrica

La distribución hipergeométrica es especialmente útil en todos aquellos casos en los que se extraigan muestras o se realicen experiencias repetidas sin devolución del elemento extraído o sin retornar a la situación experimental inicial.
Es una distribución fundamental en el estudio de muestras pequeñas de poblaciones pequeñas y en el cálculo de probabilidades de juegos de azar. Tiene grandes aplicaciones en el control de calidad para  procesos experimentales en los que no es posible retornar a la situación de partida.

Las consideraciones a tener en cuenta en una distribución hipergeométrica:
  • El proceso consta de "n" pruebas, separadas o separables de entre un conjunto de "N" pruebas posibles.
  • Cada una de las pruebas puede dar únicamente dos resultados mutuamente excluyentes.
  • El número de individuos que presentan la característica A (éxito) es "k".
  • En la primera prueba las probabilidades son: P(A)= p y P(A)= q; con p+q=1.

En estas condiciones, se define la variable aleatoria X = “nº de éxitos obtenidos”. La función de probabilidad de esta variable sería:

Función de probabilidad de la distribución hipergeométrica

La media, varianza y desviación típica de esta distribución vienen dadas por:

Media, varianza y desviación de la distribución hipergeométrica

EJEMPLO 1:
Supongamos la extracción aleatoria de 8 elementos de un conjunto formado por 40 elementos totales (cartas baraja española) de los cuales 10 son del tipo A (salir oro) y 30 son del tipo complementario (no salir oro).
Si realizamos las extracciones sin devolver los elementos extraídos y llamamos X al número de elementos del tipo A (oros obtenidos) que extraemos en las 8 cartas; X seguirá una distribución hipergeométrica de parámetros 40 , 8 , 10/40.H(40,8,0,25).
Para calcular la probabilidad de obtener 4 oros:
Solución problema 1

EJEMPLO 2:
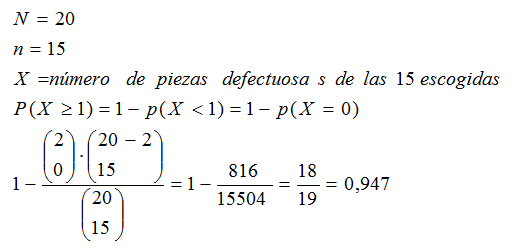
De cada 20 piezas fabricadas por una máquina, hay 2 que son defectuosas. Para realizar un   control de calidad, se observan 15 elementos y se rechaza el lote si hay alguna que sea defectuoso. Vamos a calcular la probabilidad de que el lote sea rechazado.
Solución problema 2


Cuando N es muy grande, como criterio se suele considerar N > 10n, la distribución hipergeométrica se puede aproximar por la binomial B( n, p ) con p = k/N.

En la siguiente escena puedes observar la función de probabilidad de la distribución hipergeométrica. Puedes cambiar los diferentes parámetros que configuran dicha distribución y observar como cambia esta función a medida que se varía alguno de ellos. Extrae tus propias conclusiones. Así mismo, puedes utilizar también la escena como calculadora directa que permite resolver situaciones concretas que se puedan plantear en problemas específicos. Lógicamente hay un límite para los valores de la población de manera que la escena funcione con fluidez (valores menores de 200). 

Ejercicio propuesto 
En una urna o recipiente hay un total de N objetos, entre los cuales hay una cantidad a de objetos que son defectuosos, si se seleccionan de esta urna n objetos al azar, y sin reemplazo, ¿cuál es la probabilidad de obtener x objetos defectuosos?

Prueba t de Student

En estadística, una prueba t de Student, prueba t de estudiante, o Test-T es cualquier prueba en la que el estadístico utilizado tiene una distribución t de Student si la hipótesis nula es cierta. Se aplica cuando la población estudiada sigue una distribución normal pero el tamaño muestral es demasiado pequeño como para que el estadístico en el que está basada la inferencia esté normalmente distribuido, utilizándose una estimación de la desviación típica en lugar del valor real. Es utilizado en análisis discriminante.

Esta fórmula está basada en n-1 grados de libertad (degrees of freedom). Esta terminología resulta del hecho de que si bien s2 está basada en n cantidades   . . . , éstas suman cero, así que especificar los valores de cualquier n-1 de las cantidades determina el valor restante. Por ejemplo, si n=4 y
;  y , entonces automáticamente tenemos , así que sólo tres de los cuatro valores de  están libremente determinamos 3 grados de libertad.

Entonces, en esta unidad la fórmula de grados de libertad será n-1 y su simbología 


Supóngase que se toma una muestra de una población normal con media  y varianza . Si es el promedio de las n observaciones que contiene la muestra aleatoria, entonces la distribución  es una distribución normal estándar. Supóngase que la varianza de la población 2 es desconocida. ¿Qué sucede con la distribución de esta estadística si se reemplaza  por s? La distribución t proporciona la respuesta a esta pregunta.

La media y la varianza de la distribución t son  = 0 y  para >2, respectivamente.
La siguiente figura presenta la gráfica de varias distribuciones t. La apariencia general de la distribución t es similar a la de la distribución normal estándar: ambas son simétricas y unimodales, y el valor máximo de la ordenada se alcanza en la media  = 0. Sin embargo, la distribución t tiene colas más amplias que la normal; esto es, la probabilidad de las colas es mayor que en la distribución normal. A medida que el número de grados de libertad tiende a infinito, la forma límite de la distribución t es la distribución normal estándar.

Propiedades de las distribuciones t

  1. Cada curva t tiene forma de campana con centro en 0.


  2. Cada curva t, está más dispersa que la curva normal estándar z.

  3. A medida que  aumenta, la dispersión de la curva t correspondiente disminuye.

  4. A medida que  , la secuencia de curvas t se aproxima a la curva normal estándar, por lo que la curva z recibe a veces el nombre de curva t con gl = 


La distribución de la variable aleatoria t está dada por:
Esta se conoce como la distribución t con  grados de libertad.

Sean X1, X2, . . . , Xn variables aleatorias independientes que son todas normales con media  y desviación estándar . Entonces la variable aleatoria  tiene una distribución t con  = n-1 grados de libertad.

La distribución de probabilidad de t se publicó por primera vez en 1908 en un artículo de W. S. Gosset. En esa época, Gosset era empleado de una cervecería irlandesa que desaprobaba la publicación de investigaciones de sus empleados. Para evadir esta prohibición, publicó su trabajo en secreto bajo el nombre de "Student". En consecuencia, la distribución t normalmente se llama distribución t de Student, o simplemente distribución t. Para derivar la ecuación de esta distribución, Gosset supone que las muestras se seleccionan de una población normal. Aunque esto parecería una suposición muy restrictiva, se puede mostrar que las poblaciones no normales que poseen distribuciones en forma casi de campana aún proporcionan valores de t que se aproximan muy de cerca a la distribución t.

La distribución t difiere de la de Z en que la varianza de t depende del tamaño de la muestra y siempre es mayor a uno. Unicamente cuando el tamaño de la muestra tiende a infinito las dos distribuciones serán las mismas.

Se acostumbra representar con el valor t por arriba del cual se encuentra un área igual a . Como la distribución t es simétrica alrededor de una media de cero, tenemos; es decir, el valor t que deja un área de  a la derecha y por tanto un área de  a la izquierda, es igual al valor t negativo que deja un área de  en la cola derecha de la distribución. Esto es, t0.95 = -t0.05, t0.99=-t0.01, etc.

Para encontrar los valores de t se utilizará la tabla de valores críticos de la distribución t del libro Probabilidad y Estadística para Ingenieros de los autores Walpole, Myers y Myers.

Ejemplo:
El valor t con  = 14 grados de libertad que deja un área de 0.025 a la izquierda, y por tanto un área de 0.975 a la derecha, es
t0.975=-t0.025 = -2.145
Si se observa la tabla, el área sombreada de la curva es de la cola derecha, es por esto que se tiene que hacer la resta de . La manera de encontrar el valor de t es buscar el valor de  en el primer renglón de la tabla y luego buscar los grados de libertad en la primer columna y donde se intercepten  y  se obtendrá el valor de t.

Ejemplo:
Encuentre la probabilidad de –t0.025 < t < t0.05.
Solución:
Como t0.05 deja un área de 0.05 a la derecha, y –t0.025 deja un área de 0.025 a la izquierda, encontramos un área total de 1-0.05-0.025 = 0.925.

P( –t0.025 < t < t0.05) = 0.925


EJERCICIOS RESUELTOS


Ejercicios propuesto 


F de Fisher

Distribución f de Fisher. Recibió este nombre en honor a Sir Ronald Fisher, uno de los fundadores de la estadística moderna. Se usa como...